

Questa lezione presenta i principali modelli di comunicazione usati nelle reti: client-server e peer-to-peer. Nel modello client-server, un client invia una richiesta a un server, che elabora la richiesta e restituisce una risposta; esempi comuni sono il web, la posta elettronica, i database server, i file server e i game server.
La lezione chiarisce anche che client e server non sono necessariamente macchine fisiche, ma possono essere processi software in esecuzione.
Vengono poi introdotti i data center, le server farm e i rack, spiegando il loro ruolo nell’erogazione continua dei servizi digitali.
Nella parte finale viene descritto il modello peer-to-peer, in cui i dispositivi possono comunicare direttamente tra loro, condividendo risorse senza dipendere sempre da un server centrale.
Modelli di comunicazione nella rete
I dati viaggiano nella rete sotto forma di pacchetti.
Ora vediamo i modelli con cui questi pacchetti vengono scambiati tra due applicazioni.
Modello client-server
Il modello client-server è un’architettura di rete in cui un dispositivo o processo software, chiamato client, invia richieste a un altro dispositivo o processo software, chiamato server, per ottenere un servizio (Kurose & Ross, 2026; Tanenbaum et al., 2022).
La presenza di un server permette a un certo numero di client di condividerne le risorse, lasciando che sia il server a gestire gli accessi alle risorse per evitare conflitti di utilizzazione.
Molti servizi disponibili su Internet funzionano secondo il modello client-server: per esempio, quando visitiamo un sito web, il browser invia una richiesta a un server web, che restituisce la pagina richiesta.
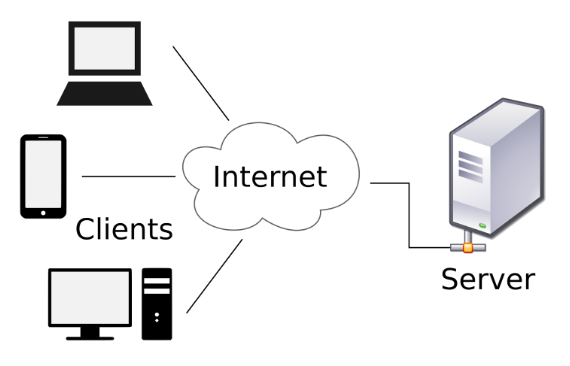
Nello specifico, nel modello client-server vediamo che sono coinvolti due processi (programmi in esecuzione) uno sulla macchina client e uno sulla macchina server.
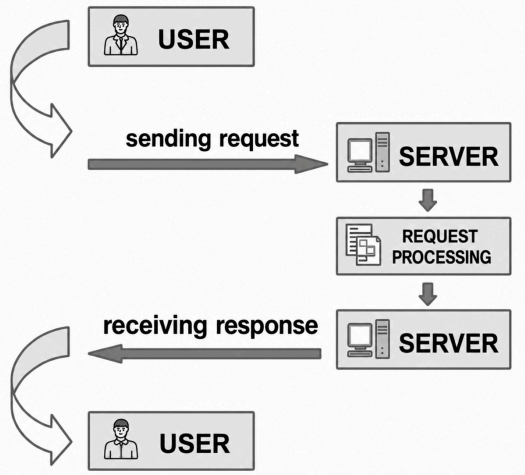
Da queste premesse, la comunicazione è rappresentata da questa logica:
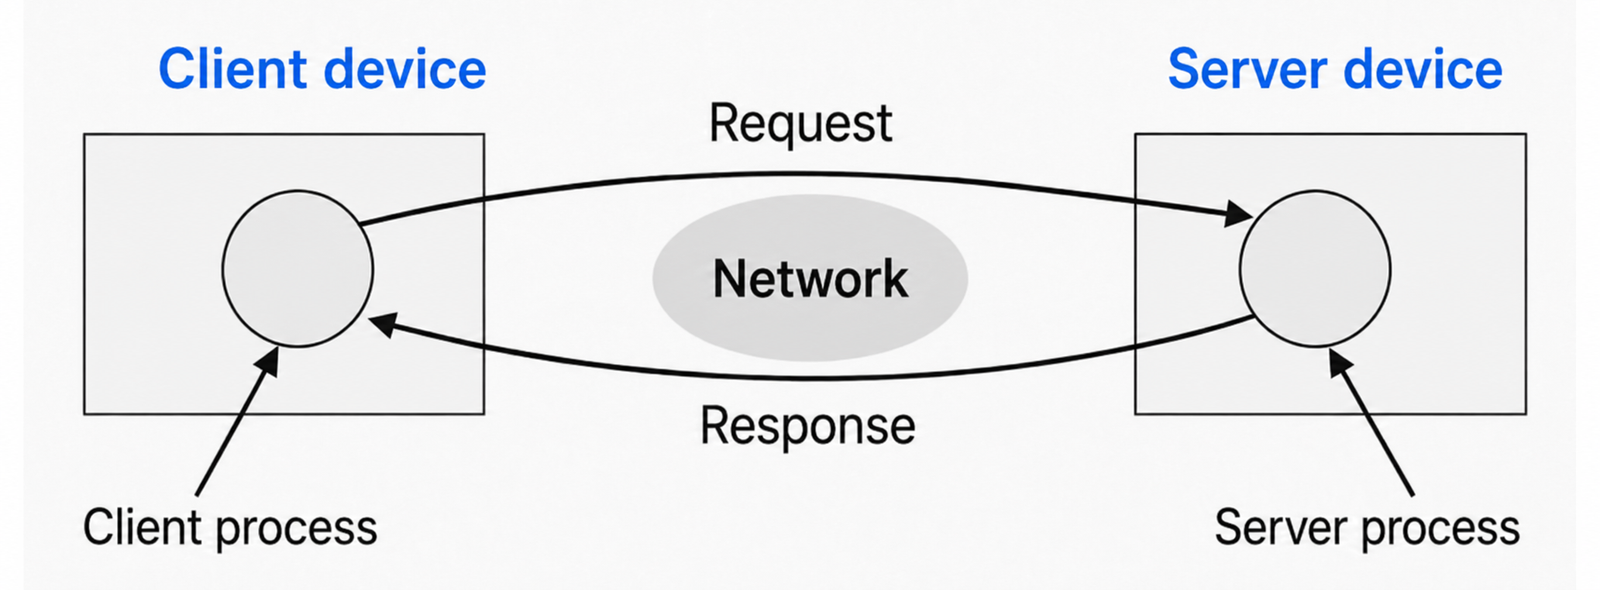
È importante specificare che un server non è necessariamente una macchina fisica: può essere anche un processo software che rimane in ascolto su una porta di rete, in attesa di richieste da parte dei client. Una stessa macchina può quindi ospitare più server contemporaneamente, cioè più applicazioni o servizi in esecuzione, ciascuno raggiungibile dai client (Kurose & Ross, 2026).
Anche il client non è necessariamente una macchina fisica: può essere un processo software che invia richieste a un server per ottenere un servizio. Una stessa macchina può eseguire più processi client contemporaneamente, per esempio un browser web, un’app di posta, un videogioco online o un’app di messaggistica.
I client e il server sono in collegamento tramite un protocollo di comunicazione, cioè un insieme di regole condivise che consentono di dialogare per uno specifico compito (Kurose & Ross, 2026).
Client
Il termine client indica un componente o sottosistema informatico che accede ai servizi o alle risorse di un server.
Il client può essere hardware o software:
Ad esempio uno dei più importanti client software è il browser, un software specializzato per recuperare e visualizzare pagine web recuperate da un server web.
In alcuni sistemi il client svolge soprattutto il ruolo di interfaccia verso il server; in altri casi, invece, può essere un software molto complesso, capace di elaborare molti dati localmente.
Esistono alcuni software, come l’email, che sono divisi in una parte client (residente ed in esecuzione sul dispositivo client) e una parte server (residente ed in esecuzione sul server).
Esempio
Quando si utilizza Gmail tramite browser o app, l’interfaccia utente è il client. I messaggi, invece, sono conservati sui sistemi server del servizio. Il client invia richieste al server, che recupera i dati e li restituisce per mostrarli all’utente.
Server
Un server (dall’inglese to serve, “servire”, dunque letteralmente «serviente, servitore») è un dispositivo o un software che fornisce servizi ad altri dispositivi o programmi, chiamati client (Tanenbaum et al., 2022).
In base al contesto, il termine “server” può indicare quindi:
Un server può occuparsi di gestire gli accessi degli utenti, assegnare e liberare risorse, condividere dati e proteggere le informazioni.
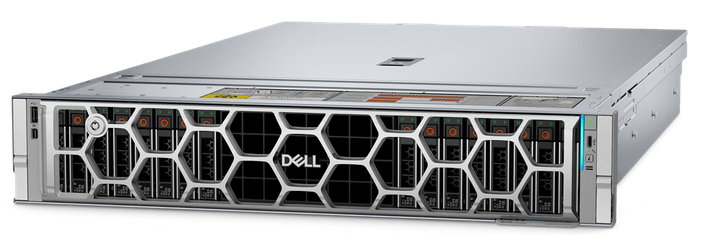
Esempio
Un server di posta elettronica è paragonabile ad un qualunque ufficio postale.
Gli utilizzatori per accedere via client alla loro casella di posta elettronica devono essere stati autorizzati.
In modo analogo un utente deve possedere la chiave della cassetta situata presso un ufficio postale dalla quale vuole prelevare la corrispondenza.
Tipi di server
In molti casi, quando parliamo di server ci riferiamo a servizi software, cioè programmi che svolgono funzioni specifiche e rispondono alle richieste dei client.
Tra i principali tipi di server troviamo:
Data center
Un data center è una struttura specializzata progettata per ospitare server e tutti gli altri componenti ad essi collegati: dispositivi di archiviazione, apparati di rete, impianti di sicurezza e infrastrutture energetiche (Barroso et al., 2026).
La funzione di un data center è quella di archiviare, elaborare e distribuire grandi volumi di dati in modo continuo, affidabile e sicuro.
In sostanza sono le “fabbriche dell’informazione”: luoghi dove i dati vivono, transitano e vengono gestiti 24 ore su 24.
Una parte fondamentale di un data center è la server farm, cioè un insieme organizzato di server installati nello stesso luogo fisico.
Una server farm è composta da armadi metallici chiamati “rack”, ciascuno dei quali contiene decine di server.

Questi server ospitano siti web, database, applicazioni aziendali, video in streaming e perfino mondi virtuali dei videogiochi online.
Oltre alla server farm, un data center è dotato di:
L’intero sistema è pensato per garantire alta disponibilità, cioè un funzionamento continuo anche in condizioni critiche (Barroso et al., 2026).
Un’interruzione di pochi secondi può significare enormi perdite economiche o danni all’immagine per chi fornisce servizi digitali.
Senza i data center, non ci sarebbe Internet per come lo conosciamo.
La maggior parte dei servizi digitali che usiamo ogni giorno, come email, messaggistica, streaming video, social network e piattaforme cloud, si appoggia a uno o più data center.
Anche i sistemi informativi delle aziende, le banche, gli ospedali, le app di navigazione o i servizi pubblici digitali si appoggiano a queste infrastrutture.

Modello peer-to-peer
Molti servizi disponibili su Internet utilizzano il modello client-server ma esiste un altro popolare modello: il peer-to-peer (P2P).
Una rete peer-to-peer è un modello di rete in cui i dispositivi collegati, chiamati peer, possono comunicare direttamente tra loro senza dipendere necessariamente da un server centrale (Kurose & Ross, 2026; Tanenbaum et al., 2022).
La parola inglese peer significa “pari”. Questo ci aiuta a capire il concetto principale: in una rete peer-to-peer i computer non sono divisi rigidamente in client e server, ma possono svolgere entrambi i ruoli.
Un dispositivo può quindi:
Ogni peer può comportarsi sia da client, quando richiede una risorsa, sia da server, quando la fornisce.
Nel modello client-server, la comunicazione è organizzata intorno a uno o più server principali. I client non comunicano sempre direttamente tra loro, ma spesso passano attraverso il server.
Per esempio, quando visitiamo un sito web, il nostro browser è il client e il server web è il sistema che ospita le pagine richieste. Il client invia una richiesta, il server risponde inviando i dati necessari.
Nel modello peer-to-peer, invece, i dispositivi possono scambiarsi dati direttamente.
Non c’è necessariamente un server centrale che controlla tutta la comunicazione.
Questa è la differenza più importante: il client-server è più centralizzato, mentre il peer-to-peer è più distribuito (Kurose & Ross, 2026).

Ogni peer può mettere a disposizione una parte delle proprie risorse, per esempio: file, spazio di archiviazione, potenza di calcolo, informazioni utili al funzionamento del sistema, ecc.
Per questo motivo, in una rete peer-to-peer il funzionamento complessivo dipende dalla collaborazione tra molti peer.
Esempio
Immaginiamo una classe in cui tutti gli studenti hanno un file diverso sul proprio computer.
Non tutte le reti peer-to-peer funzionano nello stesso modo. Possiamo distinguere, in modo semplificato, tra reti P2P pure e reti P2P ibride.
Uno degli usi più conosciuti delle reti peer-to-peer è la condivisione di file.
In un sistema di file sharing P2P, un file può essere diviso in tante parti.
Ogni peer può scaricare alcune parti del file da peer diversi e, allo stesso tempo, condividere con altri le parti che possiede già.
Questo meccanismo è molto diverso dal download tradizionale da un unico server. Nel modello client-server, se molti utenti scaricano lo stesso file dallo stesso server, quel server può sovraccaricarsi. Nel modello P2P, invece, più utenti partecipano alla rete e più aumentano le possibili fonti da cui scaricare (Kurose & Ross, 2026).
Per questo motivo il P2P può essere molto efficiente nella distribuzione di grandi quantità di dati.
Il modello peer-to-peer presenta diversi vantaggi:
Il modello peer-to-peer presenta però anche alcuni svantaggi:
Una delle domande fondamentali in una rete peer-to-peer è: come fa un peer a trovare gli altri peer?
Nel modello client-server il client conosce l’indirizzo del server, per esempio tramite un URL o un indirizzo IP. Nel modello P2P, invece, i peer possono essere molti, cambiare nel tempo e collegarsi da reti diverse.
Per risolvere questo problema, le reti P2P possono usare diversi meccanismi di scoperta.
Torrent
Uno degli esempi più conosciuti di tecnologia peer-to-peer è BitTorrent.
Nel linguaggio comune, però, si usa spesso la parola “torrent” per indicare un sistema di download basato sul protocollo BitTorrent.
BitTorrent è un protocollo di comunicazione pensato per distribuire file tra molti dispositivi collegati in rete (Cohen, 2008).
A differenza del download tradizionale, in cui un client scarica un file da un unico server, nel sistema torrent il file viene distribuito tra molti utenti.
Ogni utente che partecipa allo scambio è un peer. Questo significa che può sia ricevere dati sia inviarli agli altri.
Nel download tradizionale, il funzionamento è abbastanza semplice: il client invia una richiesta a un server e il server invia il file richiesto.
Per esempio, se scarichiamo un programma dal sito ufficiale del produttore, il nostro computer si collega al server dell’azienda e riceve da lì il file completo.
Nel torrent, invece, il file non arriva necessariamente da un unico server. Il file viene diviso in tante piccole parti, chiamate pezzi o blocchi. Il nostro computer può scaricare alcuni pezzi da un peer, altri pezzi da un altro peer, e così via (Cohen, 2008).
Allo stesso tempo, mentre scarichiamo, possiamo anche condividere con altri utenti i pezzi che abbiamo già ricevuto.
Questo è il punto fondamentale: in un sistema torrent, chi scarica può anche contribuire alla distribuzione del file.
Per avviare un download torrent, spesso si usa un piccolo file con estensione “.torrent”.
Questo file non contiene il contenuto vero e proprio che vogliamo scaricare. Per esempio, se vogliamo scaricare un video, il file .torrent non contiene il video completo.
Il file .torrent contiene invece informazioni utili al programma torrent, come:
Quindi il file .torrent è una specie di “mappa” che permette al programma di sapere cosa deve cercare e come ricostruire il file finale (Cohen, 2008).
Per usare un torrent serve un programma apposito, chiamato client torrent.
Esempi di client torrent sono: qBittorrent, Transmission, µTorrent, BitTorrent Web.
Il client torrent legge il file “.torrent” oppure un collegamento chiamato magnet link, cerca altri peer disponibili e inizia a scaricare i pezzi del file (Hazel & Norberg, 2008).
Il client si occupa anche di ricomporre i pezzi scaricati nell’ordine corretto, fino a ottenere il file completo.
Un magnet link è un collegamento che contiene le informazioni essenziali per identificare il file da scaricare. Invece di scaricare prima un file “.torrent”, l’utente può aprire direttamente il magnet link con il client torrent (Hazel & Norberg, 2008).
Il client usa queste informazioni per cercare altri peer e recuperare i dati necessari per iniziare il download.
Dal punto di vista dell’utente, il magnet link è spesso più pratico perché basta cliccare su un collegamento.
Nel linguaggio dei torrent si usano spesso due termini: seed e leech.
Più seed ci sono, più è facile e veloce scaricare il file, perché esistono più copie complete disponibili nella rete.
Se invece ci sono pochi seed, il download può essere lento o bloccarsi, perché alcuni pezzi del file potrebbero essere difficili da trovare.
L’insieme dei peer che stanno condividendo uno stesso file prende il nome di swarm, cioè “sciame”.
Uno swarm è quindi formato da tutti gli utenti che partecipano alla distribuzione di uno specifico contenuto: alcuni hanno il file completo, altri ne possiedono solo una parte.
Nei sistemi torrent esistono principalmente due modi per trovare i peer dello swarm di uno specifico contenuto: il tracker e la DHT.
Il tracker è un server che aiuta i peer a trovarsi tra loro. Non contiene necessariamente il file da scaricare, ma mantiene informazioni sui peer che stanno partecipando allo swarm. Quando un client torrent vuole scaricare un file, può contattare il tracker per ottenere una lista di altri peer disponibili (Cohen, 2008).
La DHT, sigla di Distributed Hash Table, cioè “tabella hash distribuita”, serve a trovare altri peer senza dipendere da un unico server centrale (Loewenstern & Norberg, 2008).
Invece di chiedere a un tracker chi sta condividendo un file, il client torrent interroga una rete distribuita composta da molti peer.
Possiamo immaginarla come una grande rubrica divisa tra tanti computer: ogni peer conosce solo una parte delle informazioni, ma collaborando con gli altri permette di trovare i peer che stanno condividendo un certo torrent.
Tramite DHT, il client non interroga tutti i peer della rete.
Usa invece le informazioni del torrent per contattare progressivamente alcuni nodi della rete distribuita, fino a trovare peer che stanno condividendo quel contenuto (Loewenstern & Norberg, 2008).
Elementi chiave
Cosa sta facendo davvero il client?
Uno studente usa contemporaneamente sul proprio computer:
Lo studente sostiene:
«Il mio computer è il client e tutti i computer a cui si collega sono server.»
Analizza la sua affermazione.
Progettare i servizi di una scuola
Una scuola vuole realizzare una propria infrastruttura informatica.
Deve offrire questi servizi:
Per ciascun servizio:
Un servizio che non può fermarsi
Una piattaforma di streaming viene utilizzata da milioni di utenti. I suoi responsabili pensano di conservare tutti i servizi necessari su alcuni server installati in una normale stanza dell’azienda.
La stanza dispone di connessione Internet e corrente elettrica, ma non possiede sistemi particolari di raffreddamento, generatori, UPS o sistemi avanzati di sicurezza.
Analizza la soluzione proposta.
Client-server o peer-to-peer?
Una scuola deve distribuire un file video da 4 GB a 500 studenti.
Sono state proposte due soluzioni.
Confronta le due soluzioni.
P2P puro o P2P ibrido?
Un’applicazione permette agli utenti di condividere direttamente file tra i loro computer.
Quando un nuovo utente apre il programma, però, il software contatta un server centrale che gli fornisce una lista di altri utenti disponibili. Una volta trovati gli altri dispositivi, i file vengono trasferiti direttamente tra gli utenti e non passano attraverso il server centrale.
Uno studente sostiene:
«Non può essere peer-to-peer perché esiste un server.»
Valuta questa affermazione.
Analizzare un download torrent
Vuoi scaricare legalmente un’immagine ISO di una distribuzione Linux attraverso BitTorrent.
Apri un magnet link con un client torrent. Il programma trova uno swarm formato da:
Durante il download, il tuo computer riceve pezzi differenti del file da diversi peer e contemporaneamente invia ad altri alcuni pezzi che possiede già.
Analizza ciò che sta avvenendo.
Per la realizzazione di questi materiali ho utilizzato strumenti di intelligenza artificiale generativa come supporto alla scrittura, in particolare per migliorare la forma del testo, riorganizzare i contenuti, correggere la formulazione e velocizzare alcune attività redazionali.
Lavorando autonomamente alla produzione di questi materiali, cerco infatti di automatizzare tutte le attività che possono esserlo, così da poter dedicare più tempo alla ricerca, alla progettazione e allo sviluppo dei contenuti.
L’intelligenza artificiale non determina però i contenuti dell’opera: la scelta degli argomenti, la struttura, le idee, le interpretazioni, gli esempi e l’impostazione didattica sono elaborati da me. L’IA viene quindi utilizzata principalmente come strumento di supporto alla produzione e alla revisione formale, mentre la responsabilità autoriale e progettuale dei contenuti rimane mia.
Salvo diversa indicazione, questo materiale è distribuito con licenza Creative Commons Attribuzione – Non commerciale – Condividi allo stesso modo 4.0 Internazionale (CC BY-NC-SA 4.0).
È quindi possibile condividere, ridistribuire, modificare e creare opere derivate a partire dal materiale, a condizione di attribuirne correttamente la paternità, di non utilizzarlo per scopi commerciali e di distribuire eventuali versioni modificate o derivate con la stessa licenza.
Vuoi aiutarmi a scrivere articoli come questo?
No responses yet